
Ao olhar o WP-Bench por categoria, a posição de um modelo na tabela geral ganha outro significado. Na rodada de 29 de setembro, adicionei GPT-6.1 Sol e Claude Sonnet 5.5 aos seis modelos que já havia testado. O Sonnet chegou ao mesmo total de Astra e Opus, mas com uma distribuição diferente de acertos.
No post anterior, expliquei como o WP-Bench avalia modelos no desenvolvimento WordPress. Aqui, aprofundo a comparação por API e tipo de tarefa.
Agora, são oito modelos, 185 tarefas por modelo e 29 categorias. Para quem desenvolve com WordPress, a pergunta que me interessa é prática: como o modelo se saiu no tipo de trabalho que eu preciso resolver? Para responder, precisamos entender também o que cada categoria testa.
Três rodadas e um empate entre três modelos
Primeiro, em 7 de setembro de 2026, executei Astra, Flash e Fable. Depois, em 23 de setembro, testei Opus, Sol e Luna. Por fim, em 29 de setembro, rodei Sol 6.1 e Sonnet 5.5.
| Modelo | Rodada de setembro | Aprovadas | Taxa de aprovação | Custo total estimado |
|---|---|---|---|---|
| GPT-6 Astra | 7 | 152/185 | 82,2% | US$ 2,4868 |
| Claude Opus 5.5 | 23 | 152/185 | 82,2% | US$ 2,1514 |
| Claude Sonnet 5.5 | 29 | 152/185 | 82,2% | US$ 1,0164 |
| GPT-6 Sol | 23 | 146/185 | 78,9% | US$ 0,7065 |
| GPT-6.1 Sol | 29 | 144/185 | 77,8% | US$ 0,4859 |
| Gemini 3.8 Flash | 7 | 140/185 | 75,7% | US$ 1,9524 |
| GPT-6 Luna | 23 | 133/185 | 71,9% | US$ 0,0638 |
| Claude Fable 5.1 | 7 | 103/185 | 55,7% | US$ 3,7255 |
A OpenAI registrou o lançamento do GPT-6.1 Sol em 29 de setembro. A Anthropic apresentou o Sonnet 5.5 em 28 de setembro. A proximidade dos lançamentos motivou a nova rodada; os resultados abaixo vêm dos meus arquivos do WP-Bench.
Astra, Opus e Sonnet empataram em 152/185 (82,2%). Já o Sol 6.1 passou em 144/185 (77,8%), contra 146/185 (78,9%) do Sol anterior. Essas posições resumem todas as tarefas, mas escondem diferenças importantes entre as categorias.
Aprovação e custo no WP-Bench por categoria
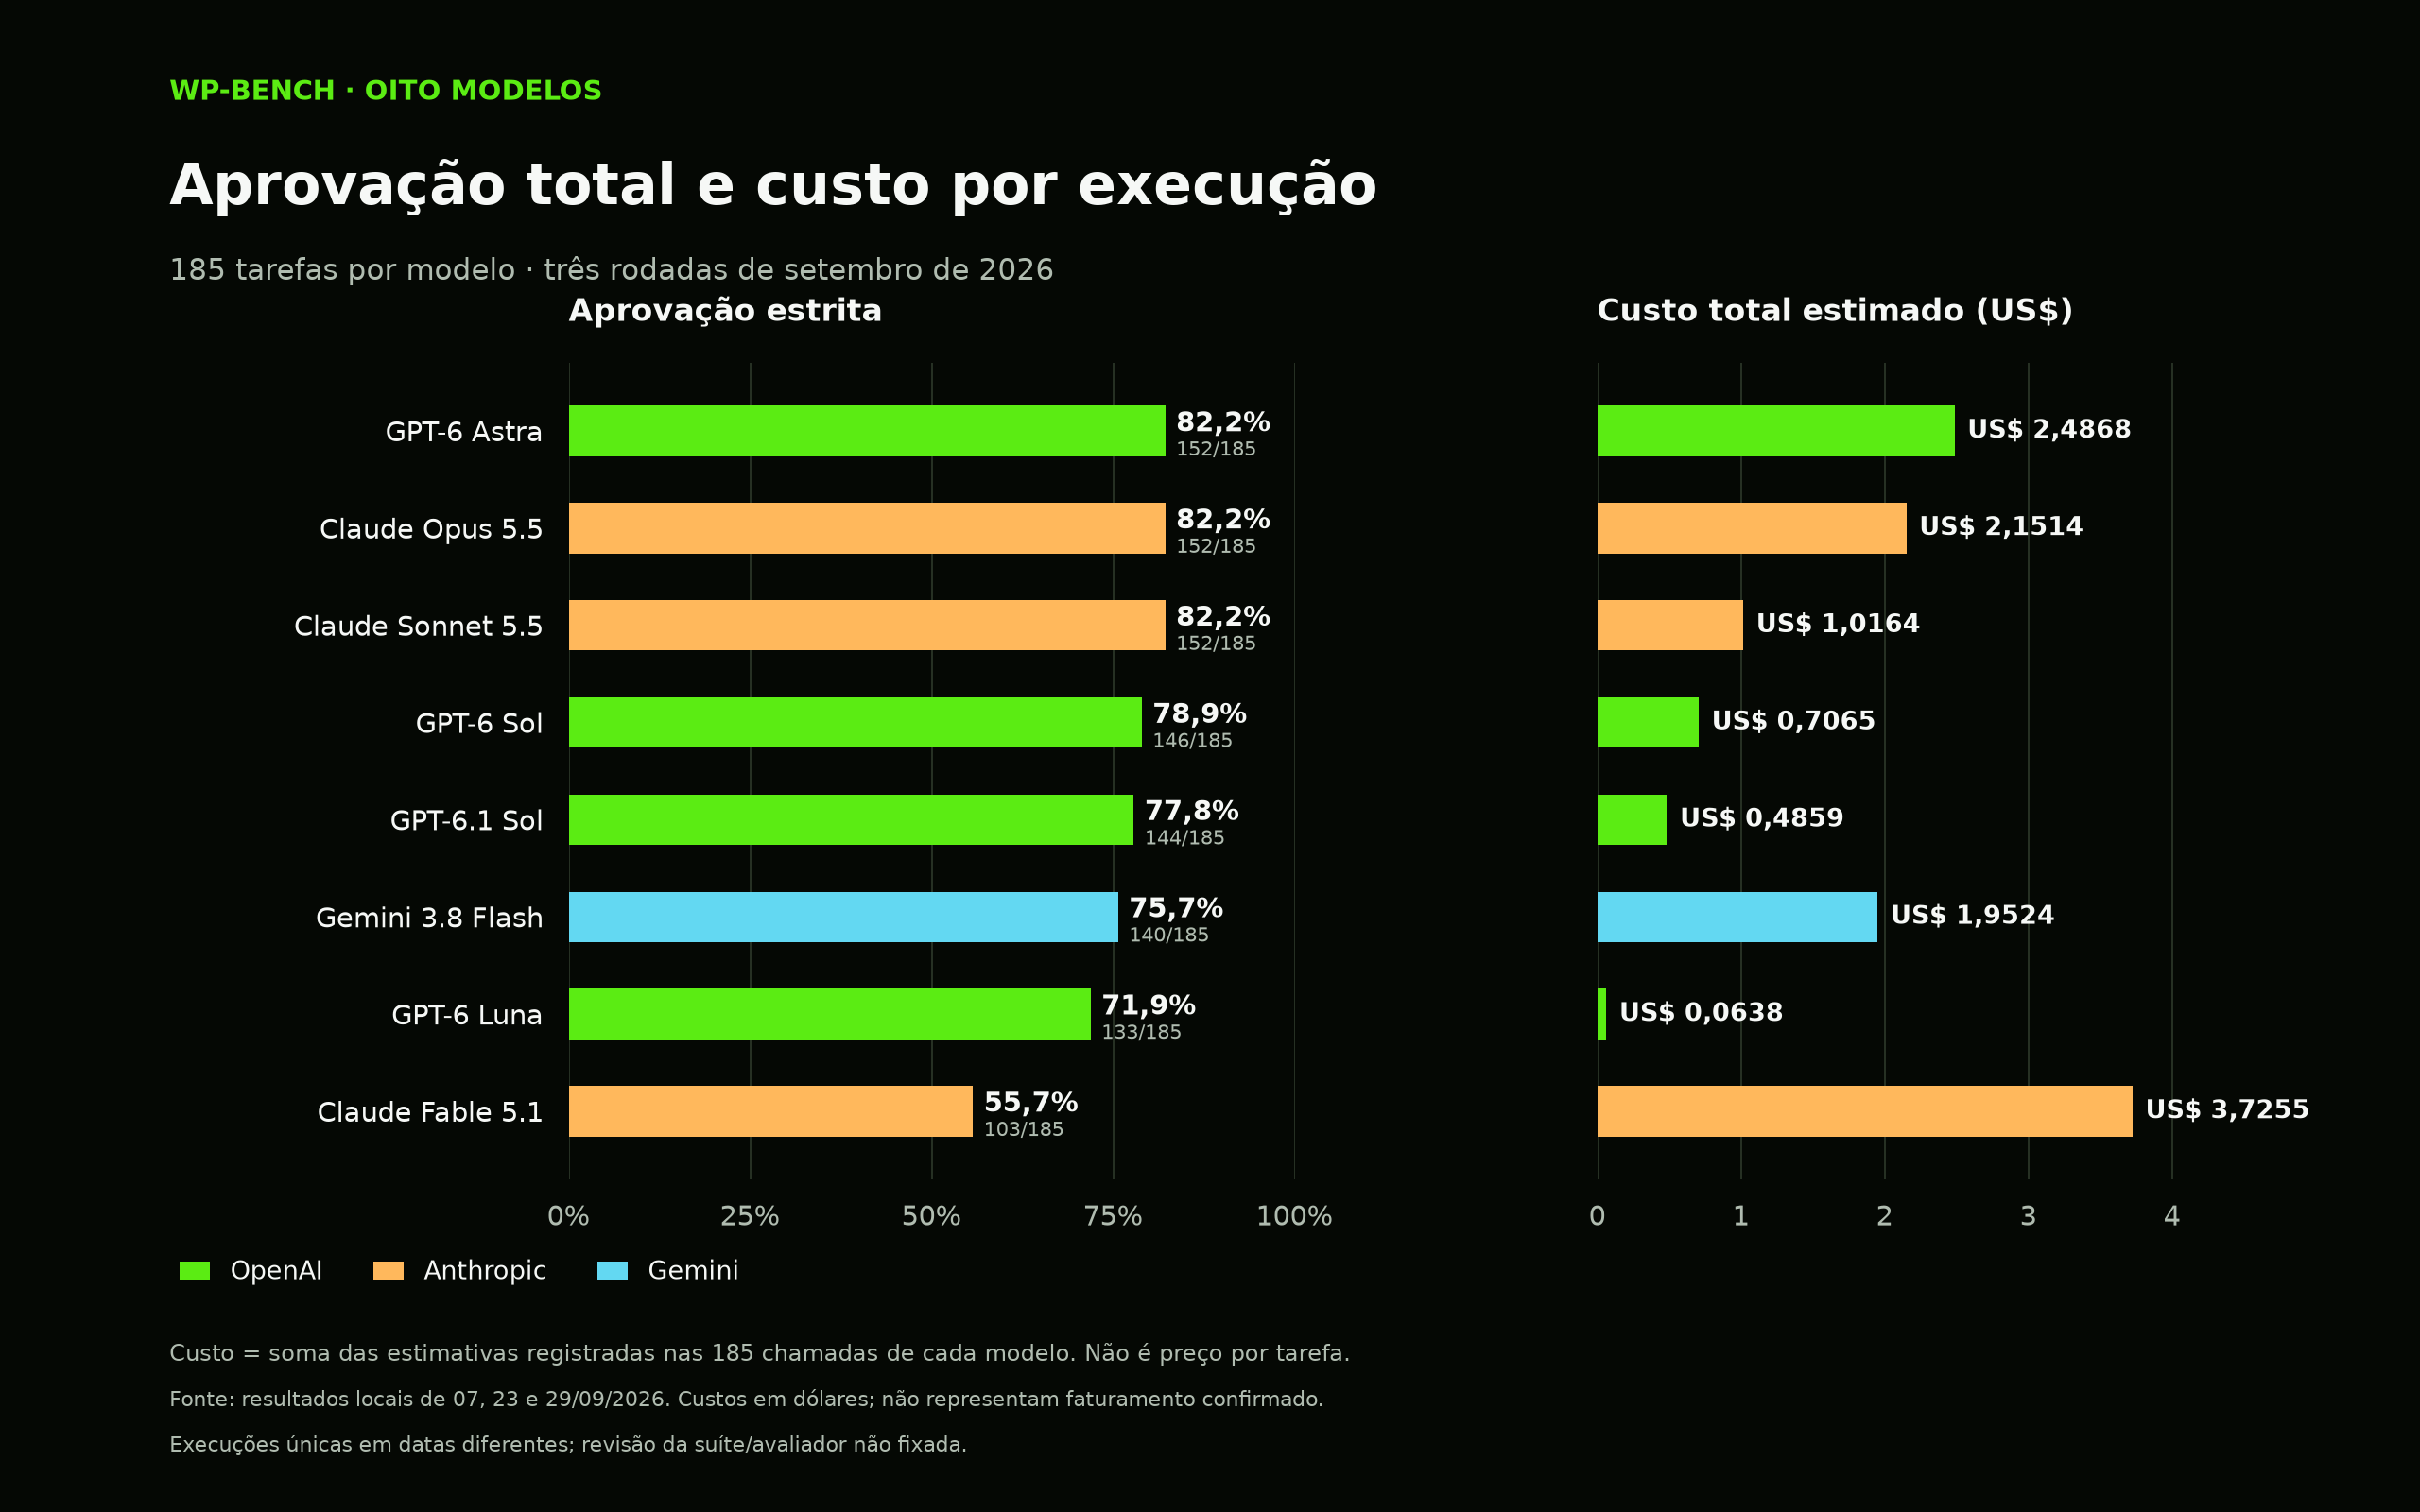
A taxa de aprovação mostra quantas tarefas passaram. Já o custo ajuda a entender quanto cada execução consumiu para chegar ao resultado. Para comparar os dois, o gráfico usa barras alinhadas: aprovação à esquerda e custo total estimado à direita.
Como calculei o custo
Somei o campo usage.cost_usd das 185 chamadas de cada modelo. Todos os registros têm esse valor. Assim, os números representam o custo estimado total das chamadas ao modelo durante a execução, em dólares.
Essa conta inclui chamadas de tarefas aprovadas e reprovadas. Porém, não inclui infraestrutura, revisão humana ou novas tentativas para corrigir o código depois do teste. Também não representa o preço atual de uma assinatura nem uma confirmação da cobrança do provedor.
O resultado depende do volume de tokens e das estimativas registradas pelo benchmark. Por isso, não basta olhar a tarifa de entrada de um modelo para prever o custo desta bateria.
Sonnet: menor custo entre os três empatados
Astra, Opus e Sonnet passaram em 152/185 tarefas, ou 82,2%. Entretanto, os custos estimados foram diferentes: US$ 2,4868 para Astra, US$ 2,1514 para Opus e US$ 1,0164 para Sonnet.
Nesse recorte, o Sonnet teve um custo aproximadamente 52,8% menor que o Opus e 59,1% menor que o Astra, com o mesmo total de aprovações. Assim, ele chama atenção quando olhamos aprovação geral e custo juntos.
Porém, o empate não garante o mesmo resultado em uma tarefa específica. Opus aprovou mais tarefas de Abilities API e cache; Astra liderou REST API; Sonnet liderou AI Client, Connectors API e marcação de blocos. Portanto, eu cruzaria o custo com a categoria antes de escolher.
Sol 6.1: menos custo, duas aprovações a menos
O Sol 6.1 registrou US$ 0,4859, contra US$ 0,7065 do Sol 6. Isso corresponde a uma redução de aproximadamente 31,2% no custo estimado destas execuções.
Por outro lado, a aprovação caiu de 146 para 144 tarefas: 78,9% contra 77,8%. A troca observada foi de menor custo por duas aprovações a menos, com ganhos e perdas em categorias diferentes.
Para decidir se essa troca serve ao meu projeto, eu olharia quais tarefas mudaram. Se a redução de custo vier acompanhada de mais trabalho de correção, a economia nas chamadas pode perder importância.
Luna: o menor custo da bateria
O Luna teve o menor custo estimado dos oito modelos: US$ 0,0638 para 185 tarefas, com 133 aprovações (71,9%). Já o Sonnet aprovou 19 tarefas a mais e teve custo total de US$ 1,0164.
Esses números mostram duas possibilidades de orçamento, mas não medem o tempo necessário para revisar e corrigir cada resposta. Por isso, eu testaria as tarefas reais do projeto antes de assumir que o menor custo de chamadas será o menor custo de desenvolvimento.
Além disso, Flash e Fable mostram que gastar mais não garantiu mais aprovações nessa bateria. Flash registrou US$ 1,9524 para 140 tarefas aprovadas; Fable, US$ 3,7255 para 103. As categorias ajudam a identificar onde esses modelos ainda tiveram bons resultados.
As rodadas aconteceram em datas diferentes e usam estimativas registradas nos respectivos arquivos. Portanto, essas diferenças descrevem o experimento; uma execução por modelo não estabelece uma relação universal entre preço e qualidade.
Como o WP-Bench testa o código
O WP-Bench usa o WordPress para verificar código gerado por modelos. Na suíte local wp-core-v1 examinada aqui, as 185 tarefas pedem snippets PHP. Cada tarefa tem um pedido, um contrato de comportamento e verificações que o avaliador executa.
O fluxo funciona assim:
- O modelo recebe o pedido de implementação, por exemplo, criar um endpoint ou registrar um bloco.
- O benchmark extrai o código da resposta e o entrega ao runtime WordPress.
- O avaliador prepara dados e condições de teste, executa o código e verifica o comportamento esperado.
- O relatório registra a aprovação da tarefa, as verificações atendidas e os detalhes das falhas.
Nessas rodadas, os arquivos registram baseline sem skills, ambiente Docker e reset_per_test, que reinicializa o WordPress entre tarefas. O limite de execução do avaliador é de 90 segundos por tarefa. Não houve uma sequência de edição e correção pelo modelo após receber os resultados dos testes.
O que significa uma tarefa aprovada?
Uso o campo scores.execution_pass, conforme a regra de pontuação. A tarefa precisa executar sem crash ou timeout, passar nas verificações de comportamento e não violar um padrão estático proibido com severidade de erro.
Nessa versão, encontrar nomes de funções ou outros padrões exigidos no código é um diagnóstico. Isso, sozinho, não concede nem retira a aprovação. Portanto, citar a API certa na resposta não basta: a implementação precisa atender aos testes.
Já runtime representa crédito parcial pelas verificações atendidas. Aqui, não misturo essa média com a aprovação estrita. Cada célula da tabela mostra tarefas aprovadas sobre o total da categoria: 7/10 equivale a 70%.
O que são as categorias do WP-Bench?
As categorias agrupam tarefas por API ou área funcional. Elas não são níveis de dificuldade nem têm o mesmo tamanho. Marcação de blocos reúne 14 tarefas, enquanto Font Library tem apenas três.
Abaixo, organizei as 29 categorias em quatro grupos para facilitar a leitura. Esses grupos são uma organização deste post; as categorias vêm dos arquivos de teste do projeto.
Conteúdo, consultas e armazenamento
| Categoria | Tarefas | O que entra nos testes |
|---|---|---|
| Tipos de post e taxonomias | 8 | Registrar post types e taxonomias, configurar REST e capabilities, adicionar termos sem remover os anteriores. |
| Metadados de posts | 6 | Registrar campos, ler múltiplos valores, atualizar contadores e guardar JSON sem corromper escapes. |
| Consultas | 12 | Usar WP_Query e consultas de usuários, comentários e termos, com filtros, status e critérios específicos. |
| Banco de dados | 6 | Inserir, consultar, atualizar e excluir dados em tabelas com prefixo WordPress e usar a atualização de schema. |
| Cache | 6 | Object cache, transients, limpeza de cache e distinção entre um valor false armazenado e um cache miss. |
| Comentários e usuários | 4 | Criar usuários, consultar user meta, adicionar comentários e contar comentários aprovados. |
| Mídia | 5 | Consultar dados de imagens, dimensões de resize, alt text de arquivos e informações de extensão/MIME. |
Consultas e banco de dados são categorias diferentes. A primeira trabalha com APIs como WP_Query; a segunda pede operações em tabelas com $wpdb e ferramentas de schema. Acertar uma delas não implica dominar a outra.
Blocos e editor
| Categoria | Tarefas | O que entra nos testes |
|---|---|---|
| Block API | 6 | Registrar blocos dinâmicos e estilos, serializar blocos e percorrer conteúdo com WP_Block_Processor. |
| Marcação de blocos | 14 | Produzir o conteúdo serializado que o editor salva, com comentários, atributos, classes e blocos aninhados. |
| Editor de blocos | 4 | Configurar presets com WP_Theme_JSON, supports de dimensões/tipografia e renderização com visibilidade. |
| Block Bindings | 4 | Registrar fontes de dados e conectar valores a atributos de blocos, incluindo post meta e contexto. |
| Block Hooks | 4 | Inserir blocos automaticamente em relação a outros, respeitando contexto e restrições de instâncias. |
| Interactivity API | 4 | Estado, contexto e processamento de diretivas no servidor. |
| Templates e navegação de blocos | 3 | Registrar template de plugin, renderizar link de navegação e registrar pattern para Navigation. |
| Font Library | 3 | Desabilitar a biblioteca via settings, registrar coleção e gerar marcação Font Face. |
Aqui, os testes são PHP e comportamento no servidor. A categoria Interactivity API não testa uma pessoa clicando em um componente no navegador. Da mesma forma, Editor de blocos não avalia toda a experiência visual do Gutenberg.
Também vale separar Block API de marcação de blocos. Registrar um bloco dinâmico no servidor é uma tarefa; produzir a estrutura que o editor serializa em post_content é outra. Um HTML visualmente parecido pode falhar se atributos, wrappers ou blocos internos estiverem diferentes.
Integrações, IA e acesso
| Categoria | Tarefas | O que entra nos testes |
|---|---|---|
| REST API | 12 | Endpoints, validação, sanitização, permissões, schemas, headers de coleção e respostas de erro. |
| Abilities API | 13 | Registrar categorias e abilities, validar inputs, executar callbacks e configurar exposição via REST. |
| AI Client | 10 | Criar prompt builders, verificar suporte, controlar filtros, tratar erros e resolver function calls de abilities. |
| Connectors API | 10 | Registrar e consultar conectores, validar IDs e autenticação, filtrar tipos e preservar dados em overrides. |
| Papéis e permissões | 8 | Roles, capabilities, permissões por usuário e mapeamento de meta capabilities para posts. |
| Segurança | 5 | Nonces, filtragem de HTML, escaping de URLs e transformação de HTML pelas APIs do WordPress. |
| E-mail e URLs | 4 | Validar e-mail, sanitizar URLs e redirects e enviar HTML com imagens incorporadas. |
AI Client mede o uso da API do WordPress. Os testes incluem impedir uma geração e conferir o erro devolvido; não são uma avaliação da qualidade de textos produzidos por um provedor externo. Connectors API também verifica registro e comportamento de conectores, sem representar uma integração completa com um serviço real.
Para entender como essas APIs se relacionam, veja o post sobre WordPress 7.0 e inteligência artificial.
Extensão e configuração do WordPress
| Categoria | Tarefas | O que entra nos testes |
|---|---|---|
| Hooks | 6 | Actions e filters, prioridades, argumentos, remoção de callbacks e contagem de execuções. |
| Shortcodes | 5 | Registrar callbacks, processar atributos, identificar/remover shortcodes e escapar conteúdo. |
| Cron | 5 | Agendar eventos únicos/recorrentes, evitar duplicatas, remover eventos e tratar schedules inválidos. |
| Configurações e opções | 5 | Settings API, sanitização, exposição REST, autoload e atualização de opções preservando dados. |
| Internacionalização | 5 | Traduções, text domains, escaping e troca temporária de locale com restauração. |
| Rewrites e permalinks | 3 | Estruturas de URL, regras de rewrite e query vars públicas. |
| Scripts e estilos | 5 | Registrar/enfileirar scripts, módulos, dependências, JavaScript inline e nomes de atributos data. |
Três exemplos do que o avaliador confere
Em REST API, a tarefa e-rest-api-002 pede um endpoint de livros com ID numérico. O avaliador verifica um ID válido e exige erro de validação para uma entrada não numérica. Uma rota que simplesmente deixa de corresponder à URL inválida e devolve 404 não atende ao contrato de validação com resposta 400.
Em consultas, e-queries-002 pede posts publicados cujo meta price_cents seja numericamente igual a zero. O avaliador prepara um post com zero, outro com preço diferente, um sem esse meta e um rascunho com zero. A consulta precisa selecionar apenas o post publicado correto.
Em cache, e-caching-001 pede distinguir ausência de cache de um valor booleano false armazenado. O valor retornado pode ser false nos dois casos; a diferença está no argumento $found de wp_cache_get(). O teste confere essa distinção.
Esses exemplos mostram por que um código convincente na conversa pode não passar. Também mostram o alcance do resultado: aprovação significa atender aos casos e condições que aquela tarefa verifica.
Onde os oito modelos se destacaram
Sonnet 5.5: novas lideranças em IA e marcação de blocos
O Sonnet liderou sozinho AI Client, com 7/10 (70%), Connectors API, com 10/10 (100%), e marcação de blocos, com 14/14 (100%). Antes dessa rodada, os maiores números eram, respectivamente, 6/10, 8/10 e 13/14.
Também dividiu a liderança em Block API com Opus (5/6) e em banco de dados com Opus e Sol 6 (6/6). Porém, ficou em 3/6 no cache, enquanto seis dos outros modelos passaram em 5/6. Em Abilities API, teve 10/13, abaixo dos 12/13 de Opus e Sol 6.
Assim, o empate geral não significa que Sonnet e Opus aprovaram as mesmas tarefas. Comparando os IDs, o Sonnet passou em nove tarefas que Opus não aprovou e deixou de passar em nove que Opus aprovou.
Sol 6.1: melhora em algumas categorias, saldo menor no total
O Sol 6.1 subiu de 4/10 para 6/10 em AI Client e de 6/12 para 7/12 em REST API em relação à execução do Sol 6. Manteve 13/14 em marcação de blocos e 10/12 em consultas.
Por outro lado, caiu de 12/13 para 11/13 em Abilities API, de 6/6 para 5/6 em banco de dados e de 3/4 para 2/4 no editor de blocos. Também perdeu uma aprovação em e-mail/URLs e em tipos de post/taxonomias.
No nível das tarefas, houve cinco novas aprovações e sete perdas, com saldo de duas tarefas a menos, ou cerca de 1,1 ponto percentual. Uma execução por modelo não permite afirmar uma regressão geral da versão; permite descrever essa diferença observada.
Astra e Opus: os destaques continuam diferentes
O Astra mantém a liderança isolada em REST API: 8/12 (66,7%). A nova rodada não mudou esse teto. Ele também passou em todas as tarefas de Block Bindings, Block Hooks, e-mail/URLs e segurança.
O Opus mantém a liderança isolada em papéis e permissões: 8/8 (100%). Em Block API, agora divide o topo com Sonnet; em Connectors API, seus 8/10 ficaram abaixo dos 10/10 do novo modelo. Em Abilities API, segue empatado com Sol 6 em 12/13.
Sol 6, Flash, Luna e Fable também têm pontos fortes
O Sol 6 divide os melhores resultados de Abilities API e banco de dados, apesar de não liderar o total. Flash e Luna tiveram 12/14 em marcação de blocos e 10/12 em consultas. Na Font Library, ambos dividem a liderança com Sonnet e Fable: 2/3.
O Fable teve o menor total, 103/185, mas aprovou todas as tarefas de Block Hooks, comentários/usuários, cron e scripts/estilos. Também empatou na liderança de consultas (10/12) e tipos de post/taxonomias (5/8, com Astra e Sol 6).
Por outro lado, Fable ficou em 0/6 no banco de dados e 2/14 na marcação de blocos. Essas diferenças reforçam a utilidade de olhar a categoria antes de extrapolar a média geral.
Desempenho por família de modelos
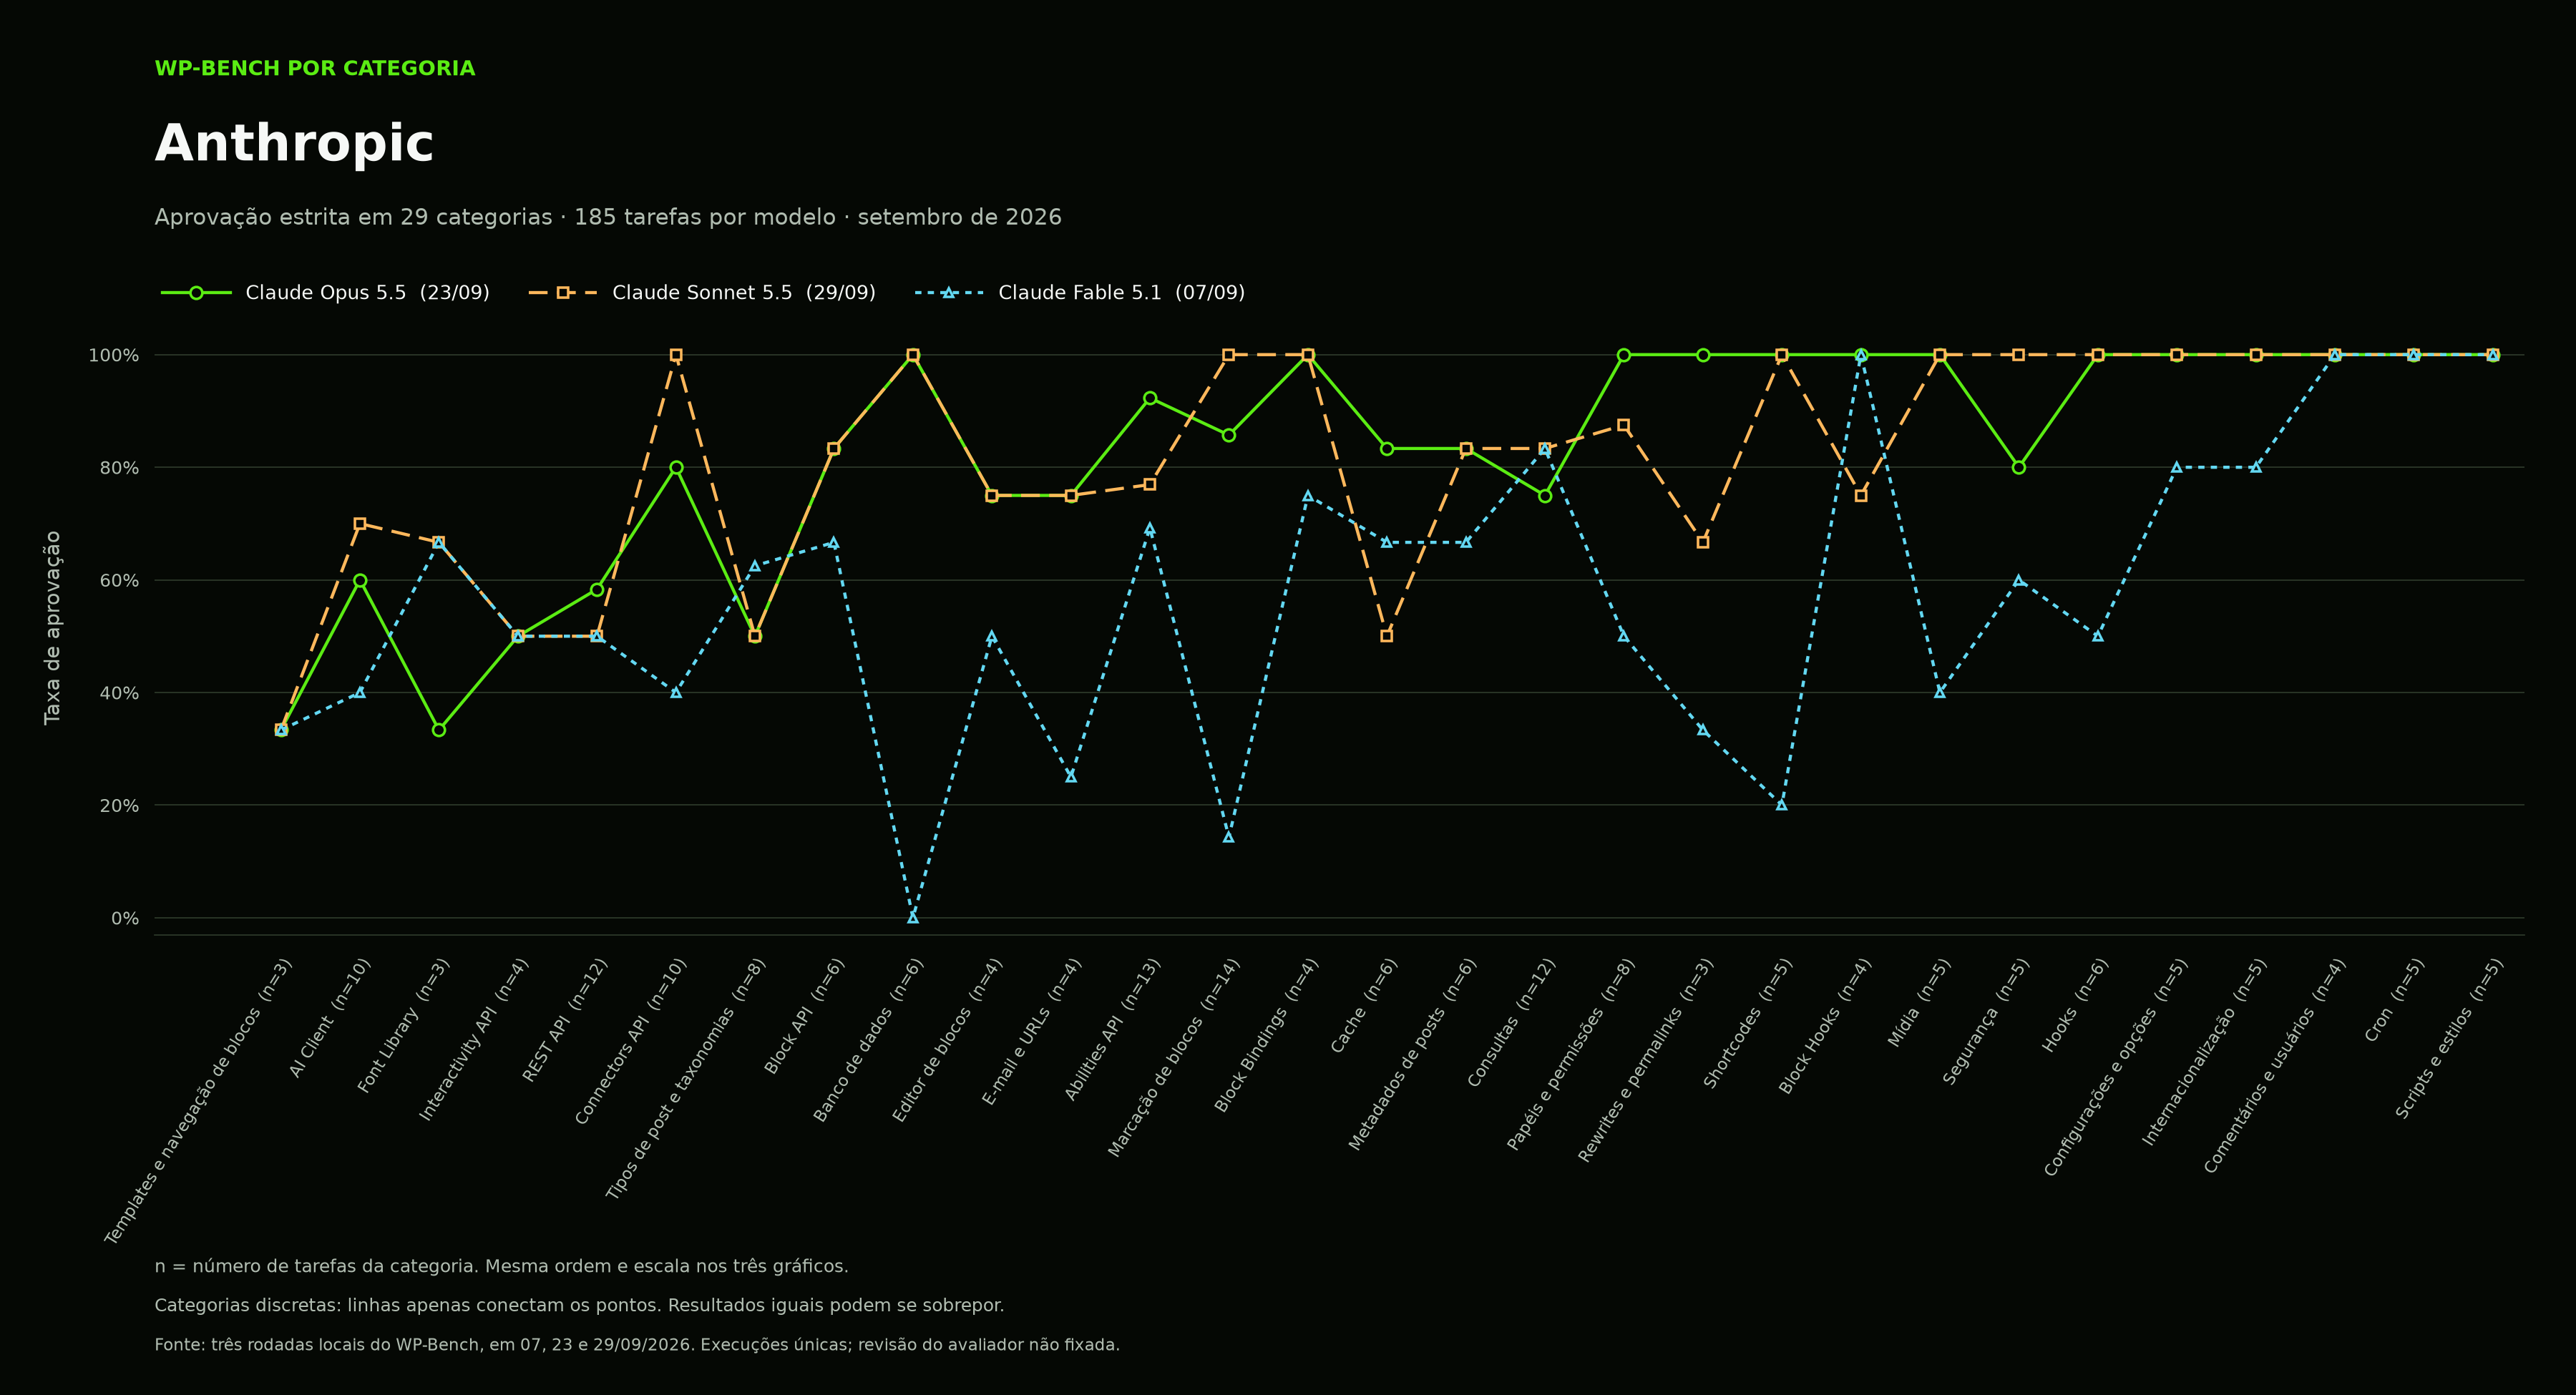
Os gráficos usam a mesma escala de 0% a 100% e a mesma ordem de categorias. Cada linha representa um modelo; o número entre parênteses no eixo indica quantas tarefas há na categoria. As linhas conectam categorias discretas, sem indicar evolução no tempo. Resultados iguais podem se sobrepor.
OpenAI

Anthropic
Gemini

Tabela completa do WP-Bench por categoria
Cada célula mostra acertos/total. Por exemplo, 5/6 equivale a 83,3%. Sonnet significa Sonnet 5.5; Opus, Opus 5.5; Flash, Gemini 3.8 Flash; Fable, Fable 5.1. Sol 6 e Sol 6.1 ficam separados.
| Categoria | Astra | Opus | Sonnet | Sol 6 | Sol 6.1 | Flash | Luna | Fable |
|---|---|---|---|---|---|---|---|---|
| Templates e navegação de blocos | 1/3 | 1/3 | 1/3 | 1/3 | 1/3 | 1/3 | 1/3 | 1/3 |
| AI Client | 6/10 | 6/10 | 7/10 | 4/10 | 6/10 | 4/10 | 6/10 | 4/10 |
| Font Library | 1/3 | 1/3 | 2/3 | 1/3 | 1/3 | 2/3 | 2/3 | 2/3 |
| Interactivity API | 2/4 | 2/4 | 2/4 | 2/4 | 2/4 | 2/4 | 2/4 | 2/4 |
| REST API | 8/12 | 7/12 | 6/12 | 6/12 | 7/12 | 6/12 | 6/12 | 6/12 |
| Connectors API | 7/10 | 8/10 | 10/10 | 5/10 | 5/10 | 5/10 | 4/10 | 4/10 |
| Tipos de post e taxonomias | 5/8 | 4/8 | 4/8 | 5/8 | 4/8 | 4/8 | 4/8 | 5/8 |
| Block API | 4/6 | 5/6 | 5/6 | 3/6 | 3/6 | 3/6 | 3/6 | 4/6 |
| Banco de dados | 5/6 | 6/6 | 6/6 | 6/6 | 5/6 | 5/6 | 2/6 | 0/6 |
| Editor de blocos | 2/4 | 3/4 | 3/4 | 3/4 | 2/4 | 3/4 | 3/4 | 2/4 |
| E-mail e URLs | 4/4 | 3/4 | 3/4 | 4/4 | 3/4 | 3/4 | 3/4 | 1/4 |
| Abilities API | 11/13 | 12/13 | 10/13 | 12/13 | 11/13 | 8/13 | 7/13 | 9/13 |
| Marcação de blocos | 13/14 | 12/14 | 14/14 | 13/14 | 13/14 | 12/14 | 12/14 | 2/14 |
| Block Bindings | 4/4 | 4/4 | 4/4 | 3/4 | 3/4 | 4/4 | 1/4 | 3/4 |
| Cache | 5/6 | 5/6 | 3/6 | 5/6 | 5/6 | 5/6 | 5/6 | 4/6 |
| Metadados de posts | 5/6 | 5/6 | 5/6 | 5/6 | 5/6 | 5/6 | 5/6 | 4/6 |
| Consultas | 10/12 | 9/12 | 10/12 | 10/12 | 10/12 | 10/12 | 10/12 | 10/12 |
| Papéis e permissões | 7/8 | 8/8 | 7/8 | 7/8 | 7/8 | 7/8 | 7/8 | 4/8 |
| Rewrites e permalinks | 3/3 | 3/3 | 2/3 | 3/3 | 3/3 | 3/3 | 2/3 | 1/3 |
| Shortcodes | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 1/5 |
| Block Hooks | 4/4 | 4/4 | 3/4 | 3/4 | 3/4 | 3/4 | 3/4 | 4/4 |
| Mídia | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 2/5 |
| Segurança | 5/5 | 4/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 3/5 |
| Hooks | 6/6 | 6/6 | 6/6 | 6/6 | 6/6 | 6/6 | 6/6 | 3/6 |
| Configurações e opções | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 4/5 |
| Internacionalização | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 4/5 |
| Comentários e usuários | 4/4 | 4/4 | 4/4 | 4/4 | 4/4 | 4/4 | 4/4 | 4/4 |
| Cron | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 |
| Scripts e estilos | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 | 5/5 |
A taxa geral usa todas as 185 tarefas. Não é a média simples dos percentuais das categorias. Assim, marcação de blocos, com 14 tarefas, pesa mais no total que Font Library, com três.
Onde há consenso e onde ainda falta aprovação
Todos os oito modelos passaram em comentários e usuários (4/4), cron (5/5) e scripts e estilos (5/5). Nessas tarefas, a aprovação não diferencia os modelos.
No outro extremo, todos ficaram em 1/3 em templates e navegação de blocos e 2/4 em Interactivity API. Em tipos de post/taxonomias, ninguém passou de 5/8; em REST API, de 8/12.
Com os novos modelos, o número de tarefas sem aprovação de ninguém caiu de 21 para 19. Isso não prova que o problema seja sempre uma limitação dos modelos. Uma falha exige olhar o pedido, o código gerado, os dados preparados e o verificador para entender o que aconteceu.
Como interpretar essas diferenças no seu projeto
Os oito modelos receberam os mesmos 185 IDs e hashes de prompt. As três rodadas também registram a mesma versão de pontuação, 3.0, e a mesma política de isolamento. Porém, a revisão do dataset não foi fixada no relatório, e a imagem Docker usa a tag latest, sem digest registrado.
Há outras diferenças de configuração: Flash e Fable registram temperatura não definida; os demais, 1,0. O código do benchmark não envia um reasoning_effort explícito. Portanto, não considero demonstrado que todos tenham sido avaliados com o mesmo esforço de raciocínio ou sob uma comparação totalmente controlada.
Além disso, são execuções únicas de tarefas delimitadas. A suíte não mede sozinha manutenção de um plugin, depuração em várias etapas, interface no navegador ou qualidade de um projeto completo. Um 100% em cinco tarefas de segurança também não substitui uma auditoria.
Na prática, eu usaria a categoria como ponto de partida. Para um endpoint, olharia REST API; para integrar uma ability, Abilities API; para produzir conteúdo de blocos, marcação de blocos. Depois, validaria o código no projeto real, com seus dados e requisitos.
O empate de Astra, Opus e Sonnet ajuda a perceber que um total igual pode esconder soluções diferentes. A escolha fica mais útil quando você relaciona os acertos ao trabalho que precisa fazer e ao que o teste realmente cobre. Para repetir a avaliação, consulte o guia de execução do WP-Bench.
Deixe um comentário